Ещё недавно, чтобы расшифровать часовой созвон, нужен был платный сервис или длинная цепочка скриптов. Сейчас модели для распознавания речи, диаризации и генерации текста стали настолько компактными, что весь конвейер запускается на обычном ноутбуке.
Меня вдохновила NVIDIA Nemotron 3 Diarization — небольшая модель (~100 МБ), которая уверенно разделяет разговор на спикеров на обычном ноутбуке. Добавляем faster-whisper для расшифровки и локальную LLM через Ollama — получается полноценный сервис без облака. Из этих компонентов я собрал проект «Подготовка протокола встречи».
Почему локально — принципиально
Для личных созвонов это удобно, для компаний — часто единственный приемлемый вариант. Причины простые:
- Конфиденциальные разговоры не уходят в сторонние сервисы. Аудио, расшифровка и протокол остаются на вашей машине.
- Нет подписок и лимитов на минуты. Можно обрабатывать столько записей, сколько позволяет железо.
- Можно работать без интернета. После установки моделей сеть не нужна.
- Данные и история остаются у вас. Сессии, имена спикеров и правки хранятся на диске, а не в чужом аккаунте.
Именно поэтому локальный контур всё чаще рассматривают не как «игрушку», а как рабочий инструмент для встреч, где есть коммерческая тайна, персональные данные или просто нежелание отдавать разговоры в облако.
Как устроен конвейер
Конвейер короткий: аудио → расшифровка → разделение по спикерам → протокол. Каждый шаг можно заменить на другую модель, не переделывая остальное.
- faster-whisper — расшифровка речи на CPU, без обращения к внешним API.
- NVIDIA Nemotron 3 Diarization — разделяет разговор на спикеров, до 8 участников.
- Локальная LLM через Ollama — собирает протокол: участники, обсуждение, решения, поручения.
Всё работает на одной машине: без облака и без отправки аудио наружу.
Что умеет сервис
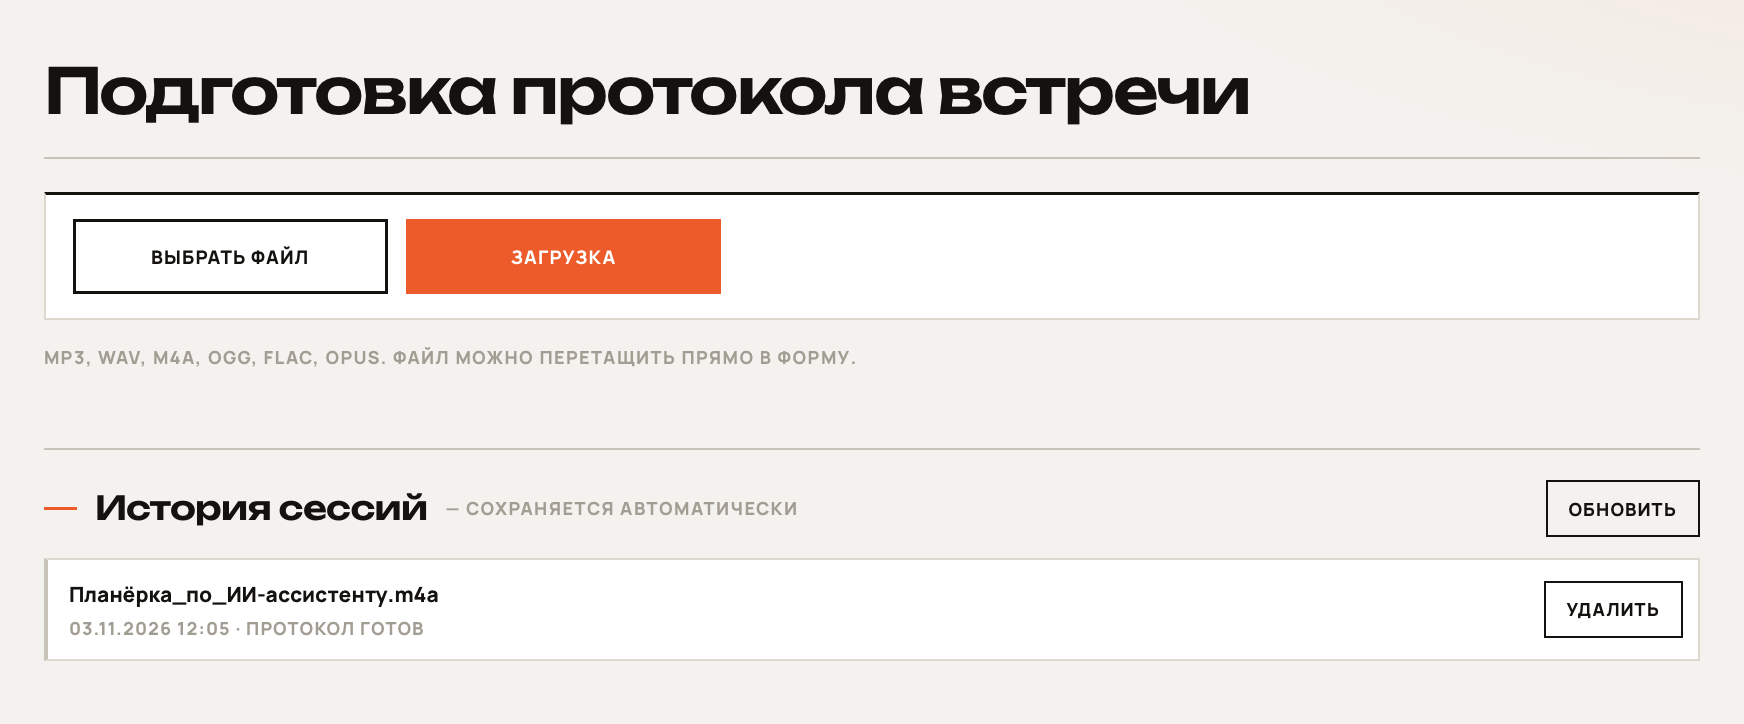
По сути это локальный ИИ-сервис подготовки протокола встречи: расшифровка, диаризация и генерация документа в одном контуре. Главный сценарий простой: закончился звонок, вы перетаскиваете запись в браузер и через несколько минут получаете черновик протокола. Дальше — проверка спорных мест и отправка документа.
- Загрузка аудио и расшифровка с разметкой по спикерам.
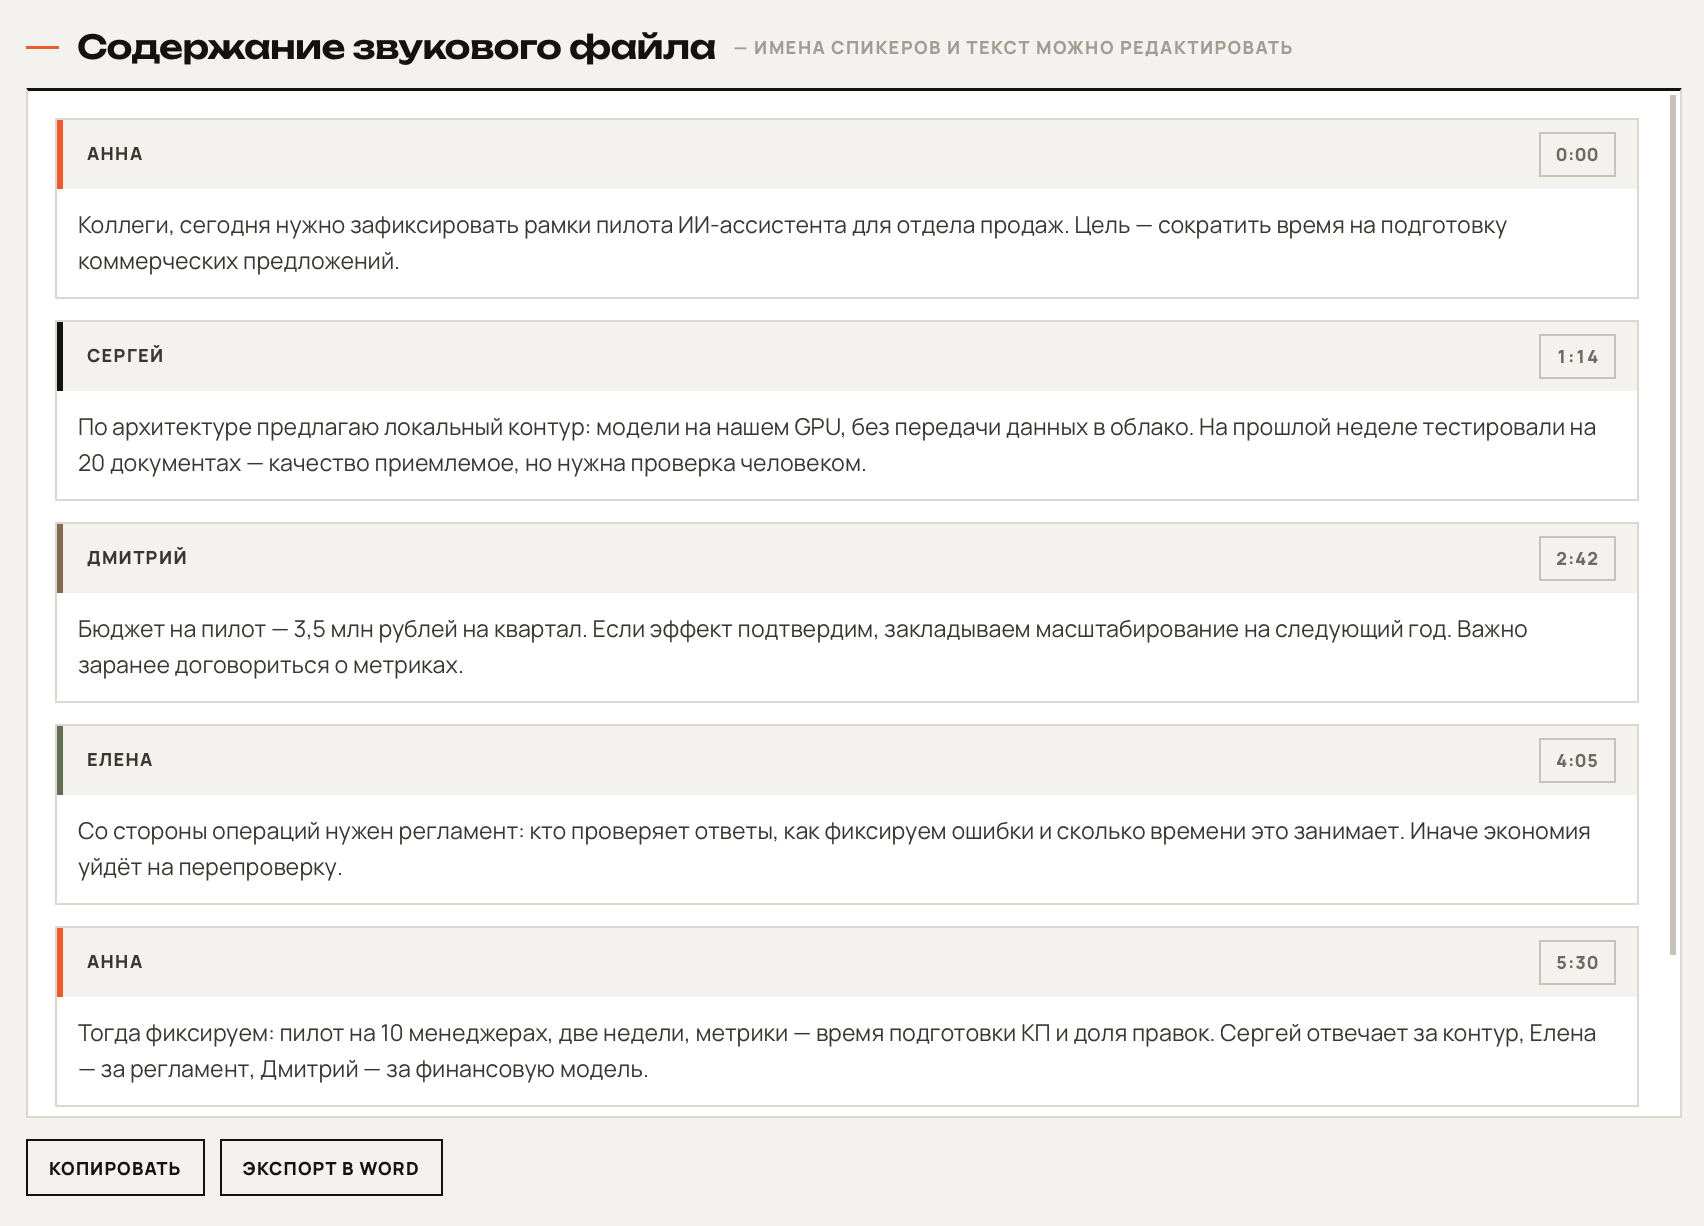
- Таймкоды и плеер: видно, кто и когда говорил; можно перейти к нужному фрагменту.
- Реальные имена спикеров: «Спикер 1» заменяется на имя в пару кликов.
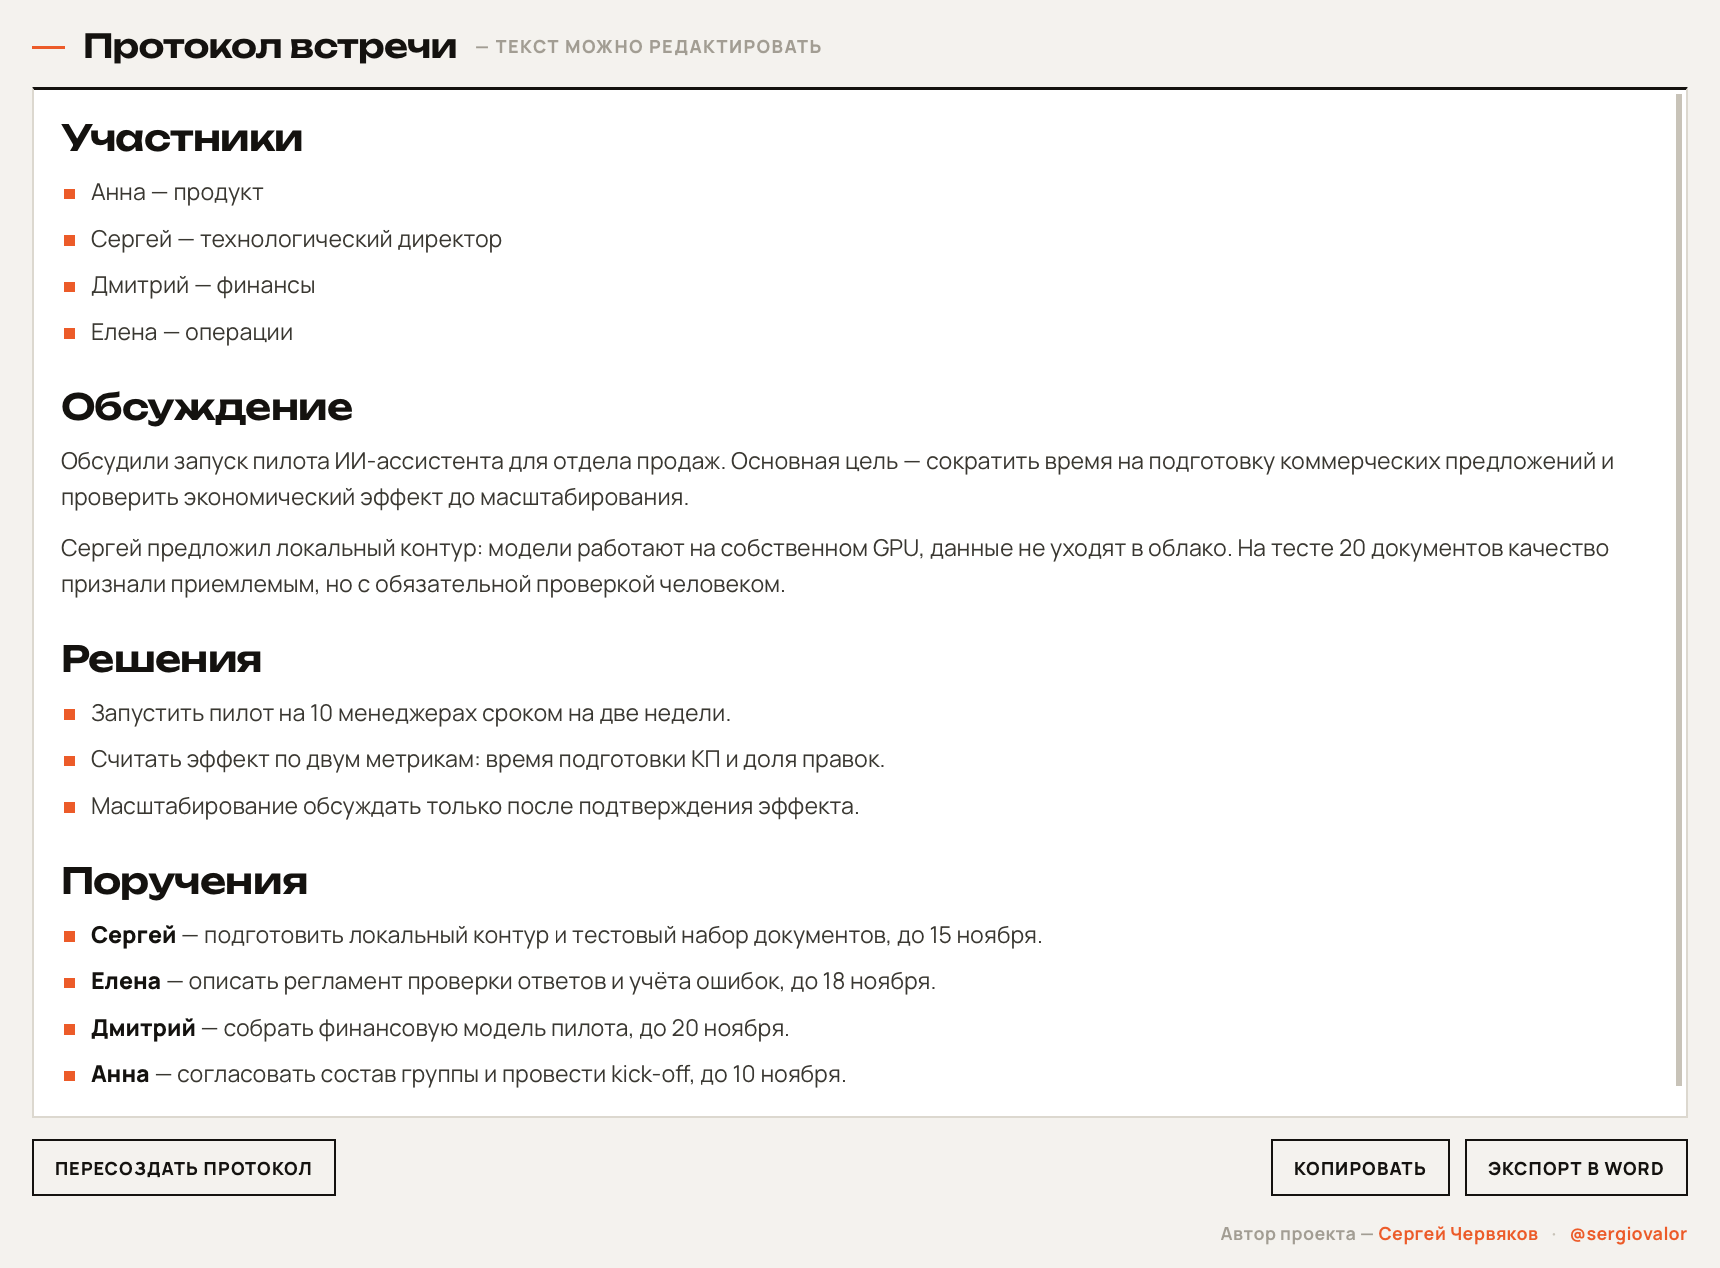
- Протокол от локальной LLM: участники, обсуждение, решения, поручения.
- Правка прямо в интерфейсе: текст расшифровки и протокол редактируются, изменения сохраняются в сессию.
- Экспорт в Word: отдельно расшифровка, отдельно протокол, с оформлением и разметкой по спикерам.
- История сессий на диске: можно вернуться, послушать аудио и продолжить правки.
Как это выглядит
Ниже — демонстрационная сессия с вымышленными участниками. На первом экране расшифровка с разметкой по спикерам и таймкодами, на втором — готовый протокол, который можно править и экспортировать в Word.
Сколько нужно ресурсов
Это посильно современному ноутбуку. Ориентиры — для Apple Silicon с 24 ГБ памяти: часовая запись — около 20 минут расшифровки и 2–3 минуты разделения по спикерам. Если памяти больше, будет быстрее; на NVIDIA GPU диаризация тоже быстрее.
- 1 минута записи — около 30 секунд расшифровки и 5–10 секунд разделения по спикерам.
- 8 минут — около 3 минут расшифровки и 19 секунд разделения.
- 60 минут — около 20 минут расшифровки и 2–3 минуты разделения.
Нужны macOS (Apple Silicon) или Linux; Windows — через WSL. Установка требует аккуратности, но отдельная серверная для часовой встречи уже не нужна.
Что важно понимать
- Качество зависит от записи. Микрофон, шум, акцент и число спикеров влияют на результат.
- Нужна проверка человеком. Это черновик протокола, а не юридически значимая стенограмма.
- Установка сложнее, чем у облачного сервиса. Нужно собрать Python-окружение и локальную LLM.
- Это рабочий прототип, а не коробочный продукт. Его можно адаптировать под процессы компании, но интеграции придётся настраивать отдельно.
Данные остаются локально, но резервные копии и место на диске — на вас.
Локальный протокол встречи — это не про «заменить людей», а про то, чтобы быстрее получить структурированный черновик и не отдавать конфиденциальный разговор в облако. Основная работа — не в моделях, а в аккуратной сборке конвейера и удобном интерфейсе для проверки.
Кому это нужно
Сценариев больше, чем кажется: личные созвоны и консультации, интервью с кандидатами, звонки с клиентами, внутренние планёрки, встречи проектных команд. Особенно там, где разговор содержит коммерческую тайну, персональные данные или просто не должен покидать контур компании.
Если вы хотите запустить такое решение у себя — для личных созвонов или в компании — напишите мне. Помогу подобрать конфигурацию под ваш ноутбук или сервер, установить и настроить под ваши задачи.
Что дальше
Такие проекты собираются из готовых небольших компонентов. Не нужно быть ML-инженером: нужно аккуратно соединить расшифровку, диаризацию и LLM, а потом сделать удобный интерфейс для проверки. Дальше — шаблоны протоколов под разные встречи, интеграции с календарём и корпоративными системами. Но базовый сценарий — запись, расшифровка, протокол, Word — уже работает локально.